Job 和 CronJob 有什么区别?拆到控制器这一层就清楚了
很多人写第一个 CronJob,会顺手填一句 schedule: "0 0 * * *",心里想的是北京时间零点。集群跑起来,任务在早上八点才动。
再往后会遇到另一种麻烦。同一个任务一晚上跑了两遍,下游的报表被覆盖了两次,第二天对账的人来问,谁也说不清第二遍是谁触发的。
这两件事都不在 Job 的定义里,也不在 CronJob 的定义里。它们分别落在时区解释和并发策略上,也就是控制器的行为里。把两个对象放到控制器这一层对照,差别会清楚很多。写之前我把官方文档和几个版本的 release note 对了一遍,涉及版本的地方在文中标出来。
三层对象
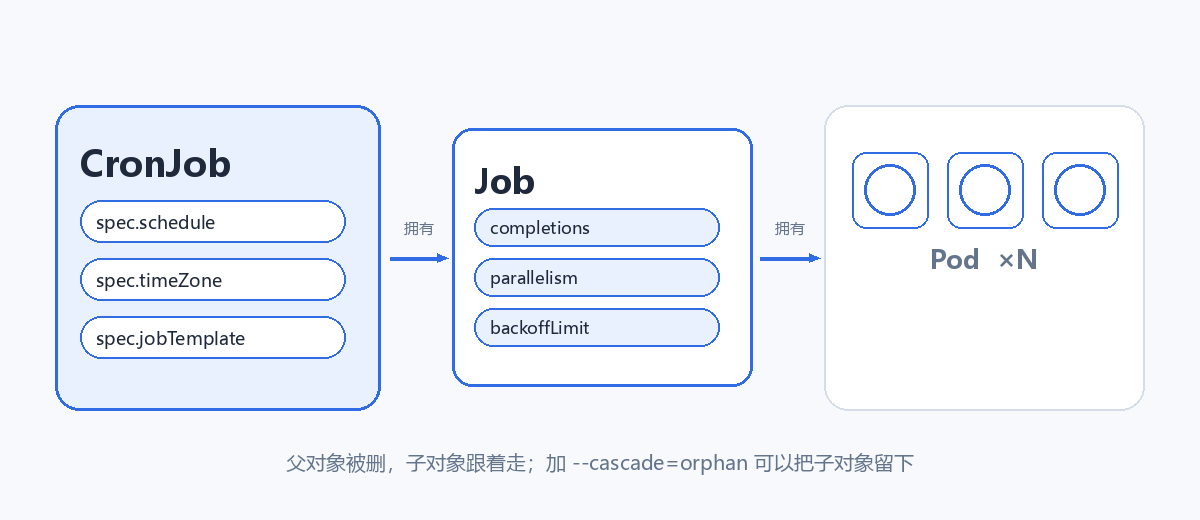
CronJob 的结构里装着一个 Job。spec.jobTemplate.spec 的类型就是 JobSpec,和单独写一个 Job 时那份 spec 一模一样。CronJob 自己不定义容器,它定义的是什么时候把这份 JobSpec 变成一个真的 Job。
于是所有权是一条三层链。CronJob 拥有 Job,Job 拥有 Pod,层与层之间靠 ownerReferences 串着,删除默认从父到子级联。删掉一个 CronJob,它历史上建过的 Job 和底下的 Pod 一起消失,除非你显式加 --cascade=orphan。
这条链也解释了日常看到的几个现象。kubectl get cj 看到的是调度,kubectl get jobs 看到的是执行记录。真在跑的容器还要再下一层,用 kubectl get pods。排障时三层要一起看,只看一层容易把结论下反。
Pod 上有 job-name 标签,新版本里还多了一份带前缀的 batch.kubernetes.io/job-name,另外有个 controller-uid。想知道某个 Job 起了哪些 Pod,kubectl get pods -l job-name=<job 名> 一般够用;标签查不到的时候,看 ownerReferences 更保险。
CronJob 建出来的 Job,名字由控制器生成,格式是 <cronjob 名>-<计划时间的 Unix 秒>,所以经常能看到 report-1735660800 这种。名字里带着时间戳,能直接反推它是哪一轮调度建的。也正因为要拼这 11 个字符,CronJob 的名字上限是 52,再多就顶破 Job 名 63 字符的线。
有一处容易想当然。Job 上除了 ownerReference,没有哪个字段天然指回 CronJob。想按 CronJob 筛 Job,最稳的办法是在 jobTemplate 里自己打一个标签,否则只能 -o json 去翻 ownerReferences。
apiVersion: batch/v1
kind: CronJob
metadata:
  name: report
spec:
  schedule: "0 2 * * *"
  timeZone: "Asia/Shanghai"        # 1.27 起稳定,不写就按 controller-manager 的本地时区
  concurrencyPolicy: Forbid        # Allow / Forbid / Replace
  startingDeadlineSeconds: 600     # 迟到超过 10 分钟的这一轮直接放弃
  suspend: false
  successfulJobsHistoryLimit: 3
  failedJobsHistoryLimit: 5
  jobTemplate:
    spec:
      backoffLimit: 2
      activeDeadlineSeconds: 1800  # 单轮硬上限 30 分钟
      ttlSecondsAfterFinished: 86400
      template:
        spec:
          restartPolicy: Never
          containers:
            - name: report
              image: registry.example.com/report:v1.4.2
              command:
                - /bin/sh
                - -c
                - /app/report --date=$(date +%F)
两个控制器,两套对账
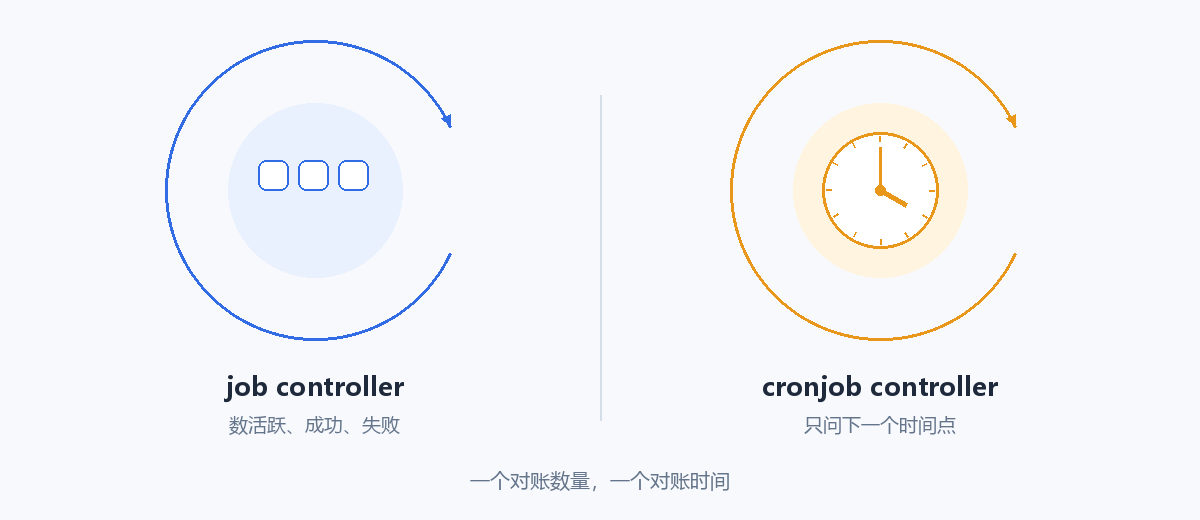
Job 的控制器只关心这一次执行。它数活跃 Pod、成功数、失败数,拿这三个数去比 completions、parallelism、backoffLimit,推着这个 Job 走到终态。
CronJob 的控制器看的是另一件事,现在这个时间点该不该多出一个 Job。它的检查间隔大约是 10 秒,所以触发精度是分钟级,实际创建时间比 schedule 晚几秒到几十秒都算正常。它从不碰 Pod,建完 Job 就交给 job controller。
这个委托关系决定了一件很关键的事。CronJob 这一层没有"执行"的概念,它的失败只有一种,Job 根本没建出来,比如配额不够、准入被拒、同一秒的名字撞了,事件 reason 是 FailedCreate。任务本身跑失败,那是 Job 的失败,CronJob 只看得到 status 里多了一个 active 或者历史里多了一个 Job。
时间写在哪
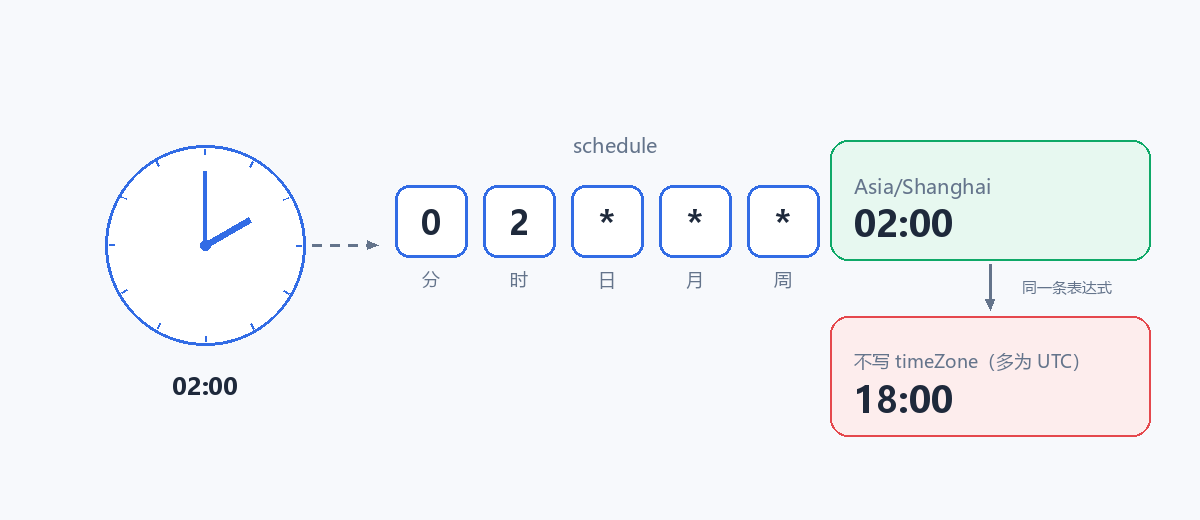
schedule 是标准五段式,分、时、日、月、周,不支持秒。写成六段会被 API 直接拒绝,这一点挡住过不少从 Linux crontab 直接抄过来的人。它也认 @daily、@hourly 这类宏,认 @every 1h30m 这种间隔写法。
宏里 @every 的行为和其他几个不一样。@daily 绑在墙上时钟上,@every 是一个相对间隔,从上次调度时间往后推,不跟整点对齐,控制器重启恢复之后的表现也就没那么直观。
别把 Quartz 的写法搬过来。L、W、? 这些符号标准解析器都不认,0 0 ? * * 会直接被拒。在 Linux crontab 里能跑的表达式,到 Kubernetes 里未必能跑。
时区是 1.27 之后才进 spec 的字段,值必须是合法的 IANA 名字,写错在准入阶段就报错。不写这个字段时,控制器按 kube-controller-manager 进程的本地时区解释 schedule,而控制面跑在容器里时那个时区通常是 UTC。开头那个八点才跑的任务,来源就在这里。老版本没有这个字段,只能把时间折算成 UTC 写进表达式,或者去改 controller-manager 的 TZ,后者会影响集群里所有 CronJob,不建议动。
显式写 timeZone: "UTC" 和不写不是一回事。不写是跟着 controller-manager 走,写 UTC 是钉死在 UTC。哪天有人动了控制面的时区,前者跟着漂,后者不动。要让行为可预期,就把它写出来。
startingDeadlineSeconds 给"迟到"划一条线。控制器恢复得比这条线晚,这一轮就丢掉,后面的照常。这个字段不设的时候,控制器恢复后会尽量补,补之前它要数从上次调度到现在错过了多少次,超过 100 次就整个放弃,事件里写的是 Cannot determine if job needs to be started: Too many missed start time (> 100). Set or decrease .spec.startingDeadlineSeconds or check clock skew。一个 suspend 了很久的 CronJob 被恢复时最容易撞上这条,处理办法是删掉重建。
suspend 这个字段名两边都有,行为不一样。CronJob 的 suspend 只停止创建新的 Job,已经在跑的那一轮不受影响。Job 的 suspend 会把自己正在跑的 Pod 删掉。一个是踩刹车等下一站,一个是直接熄火。
两轮之间

concurrencyPolicy 管的是同一个 CronJob 建出来的 Job 之间能不能重叠,三个值,Allow 是默认,Forbid 跳过,Replace 杀掉上一轮再建。
它管不到别的 CronJob。两个 CronJob 都往同一张表里写,Kubernetes 不会替你做任何协调。
Forbid 的坑是跳过就是跳过,不补。任务耗时一旦超过间隔,你会发现执行次数比预期少很多,而且没有任何报错,只有一条 Skipping 的 event。
Replace 的坑是它会删掉正在跑的 Job,包括已经写了一半的中间结果。删除是异步的,新旧两轮的 Pod 可能短暂并存,下游要是没做幂等,照样重复处理。它的适用场景其实很窄,适合那种"新一轮的结果天然覆盖上一轮"的全量任务。
Allow 不是不能用,前提是每次执行自带唯一键,下游能去重。做不到这一点,Allow 只是把问题推迟到数据层。
看 kubectl get cj 的三列能把几种情况分开。LAST SCHEDULE 停在很久以前,说明控制器压根没在调度,可能是 suspend,可能控制器没起来,也可能撞了 100 次那条线。LAST SCHEDULE 一直很新,ACTIVE 长期是 1,说明每一轮都在被 Forbid 挡。LAST SCHEDULE 很新,ACTIVE 是 0,历史里又找不到新 Job,那多半是 startingDeadlineSeconds 把迟到的这一轮丢了。
按时间走一遍更清楚。schedule 每小时一次,任务实际要跑 70 分钟,策略是 Forbid。第一轮两点开始,三点那一轮撞上还在跑的上一轮,被跳过,四点那一轮正常建。结果就是这个每小时的任务实际每两小时跑一次,日志里一个错都没有。设 startingDeadlineSeconds 救不了它,跳过发生在更前面。要么把任务压进间隔里,要么换 Replace。
一轮之内
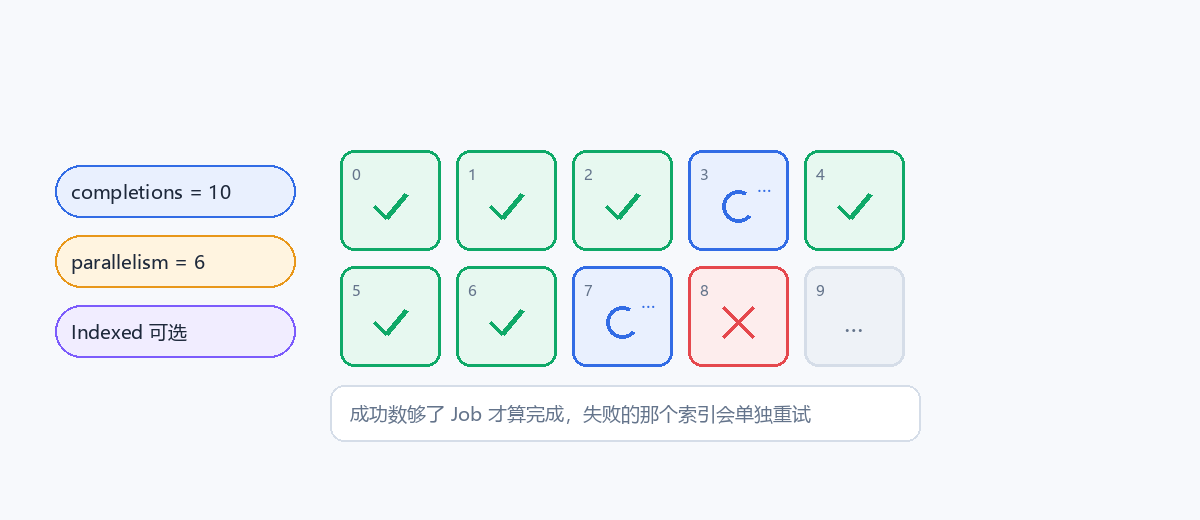
concurrencyPolicy 和 Job 的 parallelism 是两回事。前者管两轮之间能不能重叠,后者管一轮之内同时跑几个 Pod。这两个词在中文里都容易翻成"并发",混起来看会绕不出来。
Job 的执行语义靠两个字段。completions 是总数,parallelism 是并行度,默认都是 1。这两个字段组合出三种常见模式,跑一次、按固定数量并行、工作队列。
工作队列模式是把 completions 空着不写,parallelism 设成几,几个 Pod 同时启动,任意一个成功,Job 就算完成。这种写法的前提是任务本身从外部队列取活,Pod 之间自己协调。很多人省略 completions 又建了三个 Pod,结果三个 Pod 干同一件事,重复写三遍。
这里还有个容易忽略的点。CronJob 的每一轮都是一个全新的 Job,parallelism 只在那一轮里生效。上一轮跑到哪、哪些分片做完了,下一轮完全不知道。按分片切任务时,分片清单得由任务自己从外部状态里取,不能指望 Job 记住上一轮。
completionMode: Indexed 是另一套语义,1.24 稳定。每个索引一个 Pod,索引从 0 到 completions 减 1,Pod 里能读到 JOB_COMPLETION_INDEX 环境变量,主机名是 <job 名>-<索引>,配一个同名的 headless Service 之后还能拿到稳定 DNS。某个索引失败重试的是这个索引,已经完成的索引不会被重跑。每天凌晨把 100 个分片并行处理,一个 Job 带 completions 100、parallelism 10 就够了。
再往上还有几个近两年稳定的字段,都在 Job 上。podFailurePolicy 在 1.31 稳定,能把"哪些失败算数"写清楚,容器以 137 退出通常是 OOM 或者被强杀,可以用 Ignore 忽略掉;以 1 退出说明业务逻辑挂了,用 FailJob 直接判死;也可以用 Count 老老实实计入重试次数。backoffLimitPerIndex 在 1.33 稳定,让每个索引有独立的重试预算,一个分片坏掉不会把整个 Job 的重试次数吃光。successPolicy 也在 1.33 稳定,Indexed 模式下部分索引失败仍然可以判定整体成功,适合 leader 带 follower 的那种作业。
这些字段在 CronJob 里一样能用,写进 jobTemplate 就生效。这也是理解两者关系最省事的办法,CronJob 是调度器,Job 是执行语义的载体。
失败之后
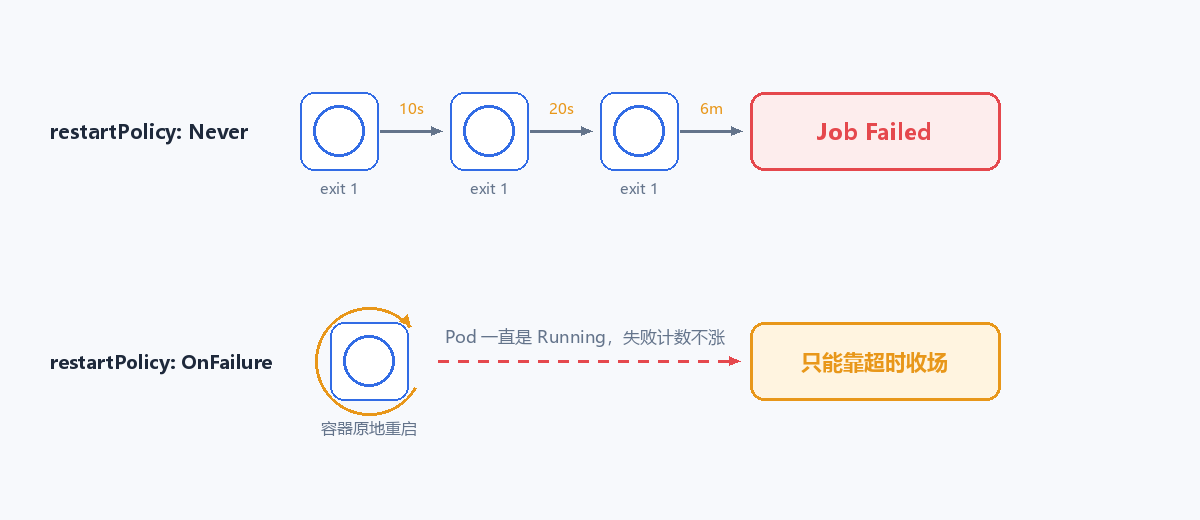
Job 的重试由 backoffLimit 控制,默认 6 次。失败之后不是立刻重来,退避从 10 秒开始翻倍,20、40、80 这样涨,封顶 6 分钟。
restartPolicy 的选择影响很大。选 Never,容器退出码非零,Pod 进 Failed,控制器建一个新 Pod,失败计数加一。选 OnFailure,容器在原来的 Pod 里重启,Pod 一直是 Running,Job 的失败计数不涨,backoffLimit 基本触发不了。一个必然失败的脚本配上 OnFailure,可以一直转到天荒地老,最后只能靠 activeDeadlineSeconds 收场。
activeDeadlineSeconds 是硬上限,从 Job 的 startTime 开始算,到点终止所有 Pod,Job 变成 Failed,reason 是 DeadlineExceeded。它比 backoffLimit 可靠,因为它不关心失败是怎么发生的。
Job 的 spec 基本是只读的。镜像、命令、环境变量改不了,改一次报一次 field is immutable,能动的只有 parallelism、suspend 这类字段。所以"线上这个 Job 挂了,改个参数重跑"这条路走不通,只能新建一个。更省事的做法是从一开始就让任务接受外部参数,配置从 ConfigMap、环境变量或者一个 JSON 文件里读,重建 Job 时只换参数不换模板。
失败的 Pod 不会自动消失。想让 backoffLimit 生效又不留垃圾,得自己配合 ttlSecondsAfterFinished,或者在排障完手动清。想看清挂在哪,趁 Pod 还在的时候 kubectl logs,或者把日志送出去。
还有一层清理藏在 kube-controller-manager 里。已终止的 Pod 累计到一定数量会触发回收,默认阈值是 12500 个,失败的 Pod 也可能被顺手带走。指望它帮你清垃圾不现实,但它确实会让你某天发现现场没了。
CronJob 这一层没有重试。一轮失败就是失败,下一个时间点再跑一轮,两轮之间没有任何关系。想让"这一轮"重试到成功,只能把重试做进 Job,或者做进脚本自己。这也意味着 CronJob 撑不起有前后依赖的任务链,明天的任务不会等今天的成功。
谁负责清理
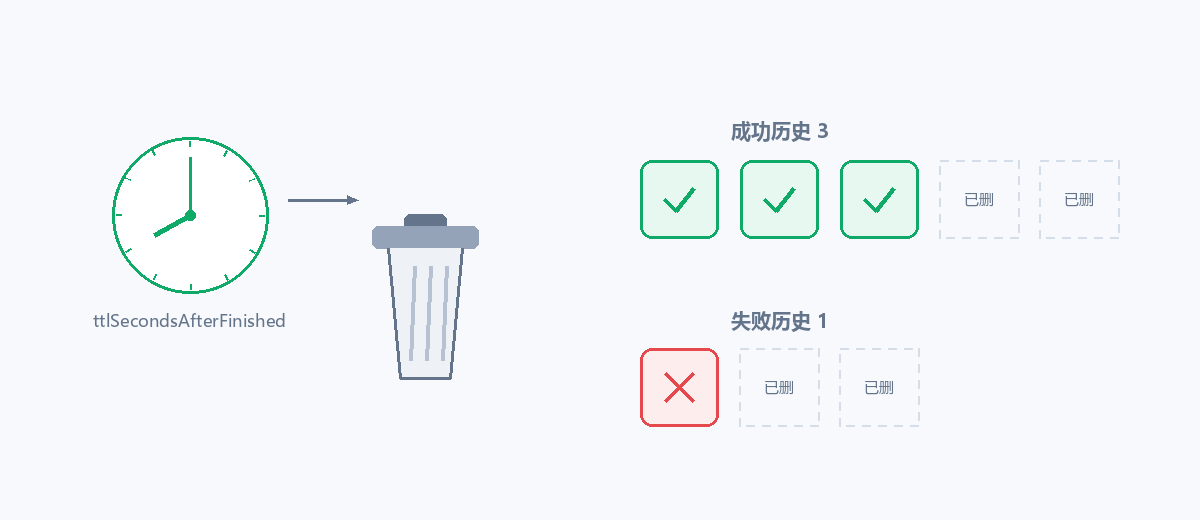
Job 跑完不会自己消失,除非设了 ttlSecondsAfterFinished,1.23 稳定。这个字段从 Job 进入终态开始计时,到点删 Job,Pod 跟着走。
CronJob 有两条历史限制,successfulJobsHistoryLimit 默认 3,failedJobsHistoryLimit 默认 1。控制器定期删掉超出的 Job,按创建时间从旧到新。
这个默认值是最该改的一个。失败 Job 只留一个,意味着第二次失败就会把第一次的证据删掉,而第一次失败的现场往往才是关键的那次。早上去查为什么挂了,Job 没了,Pod 没了,events 也过了保留期,只剩监控里一条失败计数。
ttlSecondsAfterFinished 设成 0 更狠,Job 一进终态就被删,日志一行都留不下。调试期别这么干,上线之后再收紧。
删 CronJob 会连带删掉所有历史 Job,前面提过。要留证据就先导日志,或者先 --cascade=orphan 解脱出来再删。
出问题时看哪里
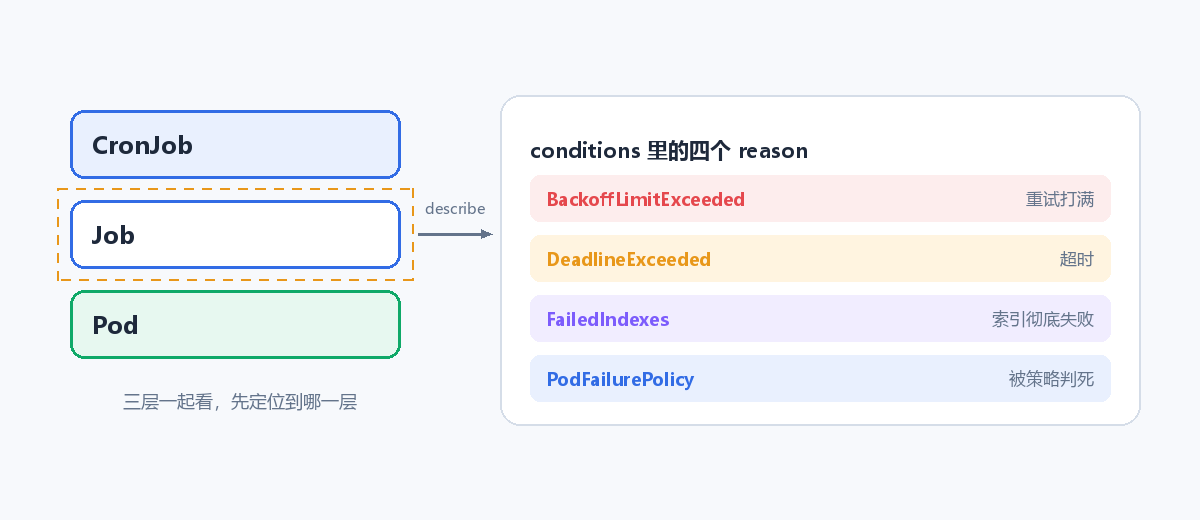
三个入口一起看。kubectl get cj 给 SUSPEND、ACTIVE、LAST SCHEDULE,kubectl get jobs 给 COMPLETIONS 和 DURATION,kubectl describe job 给 Conditions 和 Events。
Job 的 status.conditions 里 Failed 那条的 reason 基本能定方向。BackoffLimitExceeded 是重试打满,DeadlineExceeded 是超时,FailedIndexes 是 Indexed 模式下有索引彻底失败,PodFailurePolicy 是被策略判死。
status.lastSuccessfulTime 也值得看。lastScheduleTime 只说明控制器尝试过,lastSuccessfulTime 说明真的成功过,两者差得远的时候,问题在任务本身,不在调度。
时间对不上时,把三样东西摆在一起,schedule 表达式、status.lastScheduleTime、Job 的 creationTimestamp。差 8 小时是时区,差几十秒是控制器精度,差一整轮多半是 startingDeadlineSeconds 或者 Forbid 把这一轮跳过了。
# 这个 CronJob 建过哪些 Job
kubectl get jobs -o json \
  | jq -r '.items[] | select(.metadata.ownerReferences[]?.name=="report") | .metadata.name'

# 手动补一轮,不挂在这个 CronJob 名下
kubectl create job --from=cronjob/report report-manual-1

# 等它跑完,而不是 sleep 之后轮询
kubectl wait --for=condition=complete job/report-manual-1 --timeout=1800s

# 看失败原因和退出码
kubectl describe job report-manual-1 | sed -n '/Conditions/,/Events/p'
kubectl logs job/report-manual-1 --previous
手动建出来的 Job 带一条 cronjob.kubernetes.io/instantiate 注解,值是 manual,它是独立的,删 CronJob 不会删它,这一点在故障演练里很有用。
把它当模板用
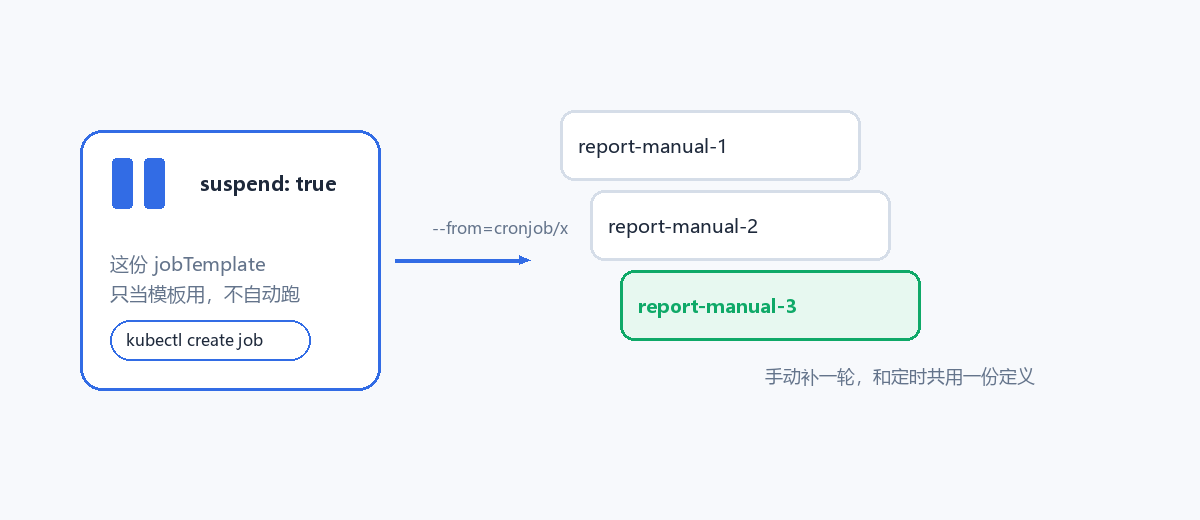
有一种用法值得单独说。CronJob 设 suspend: true,调度器就不再自动建 Job,这个对象退化成一份可复用的 jobTemplate。需要跑的时候执行 kubectl create job --from=cronjob/report report-manual-<时间戳>,镜像、命令、资源限制、重试策略全从模板里拿。定时和手动两条路共用一份定义,改动只在一个地方。
这个用法要求模板本身能独立跑起来。--from 读的是 CronJob 当前的 jobTemplate,改完模板不用发版,下一次手动触发就是新版本。代价是建出来的 Job 不挂 ownerReference,清理得自己管,模板里记得配 ttlSecondsAfterFinished,或者用完手动删。
怎么选
| 场景 | 选择 |
|---|---|
| 一次性、手动触发、CI 里的一次构建 | Job |
| 固定节奏、每次独立、能接受偶尔漏一轮 | CronJob |
| 固定节奏且绝对不能重叠 | CronJob 加 Forbid |
| 任务可能跑过调度间隔 | Forbid 加 activeDeadlineSeconds |
| 要求"上一次成功才跑下一次" | 都不合适,用 Argo Workflows 或 Airflow |
| 需要秒级精度或者大量补跑 | 外部调度器 |
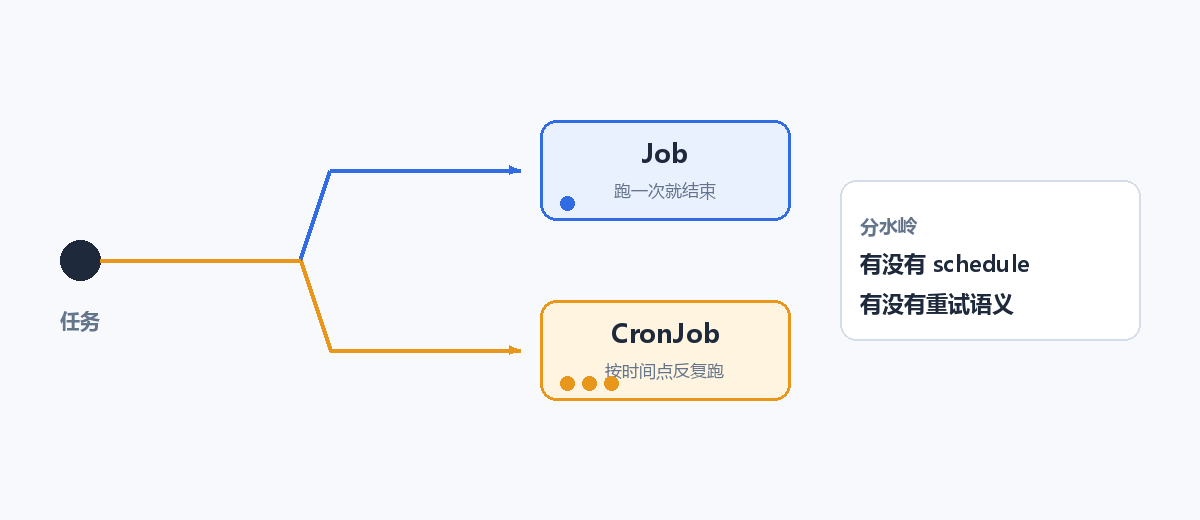
有 schedule 就是 CronJob,没有就是 Job,这条只解决表面。选型的关键在失败语义。CronJob 保证下一个时间点还会来,不保证这一轮成功。任务要求"必须成功一次",重试逻辑得自己带进去。
幂等是使用 CronJob 的前置条件,不是加分项。官方文档自己写了,一个 CronJob 在一个调度点上大约建一个 Job,偶尔建两个,偶尔一个都不建。这句话的意思是让你把任务写成可以重复执行的,而不是让你去猜它到底会建几个。
避坑清单
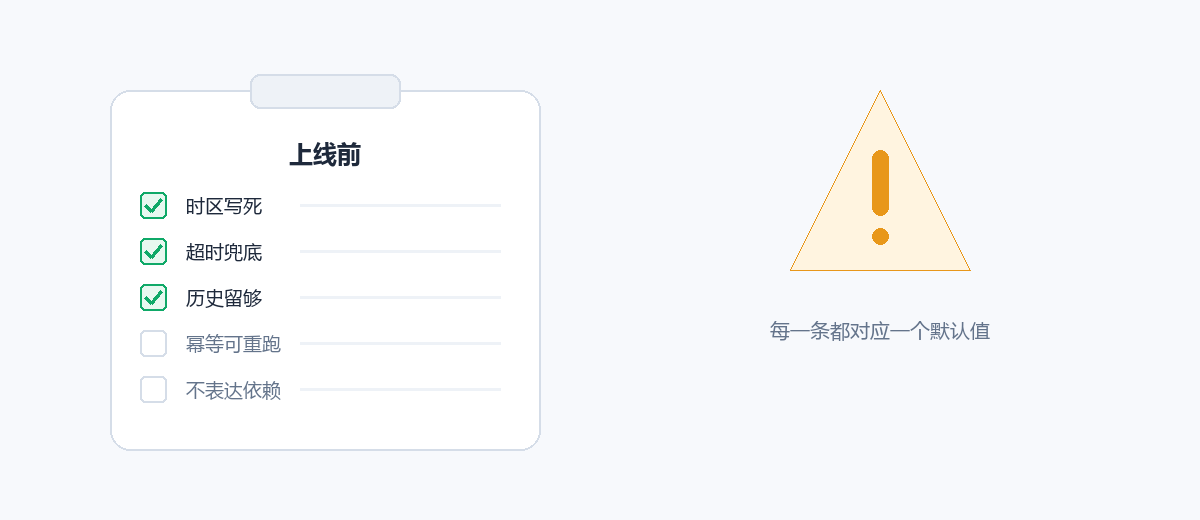
- 不要依赖默认时区,显式写 timeZone。
- 不要让 Forbid 配一个可能超时的任务,却不设 activeDeadlineSeconds。
- 不要在 jobTemplate 里改镜像后直接 apply,改不动的,先删再建。
- 不要用 failedJobsHistoryLimit 1 上生产。
- 不要在调试期设 ttlSecondsAfterFinished 0。
- 不要把 CronJob 当成任务编排,它不表达依赖。
- 不要省略 completions 又以为语义是"只跑一次"。
- 不要用 OnFailure 又不设超时。
- 不要让多个 CronJob 写同一个下游而不做去重。
- 不要在 52 字符的边缘试探 CronJob 的名字。
最后几句
两个对象的差别,最后落在两个问题上。这一次要不要跑完,下一次什么时候来。前者归 Job,后者归 CronJob,中间的交界处就是你写 jobTemplate 的那几行。